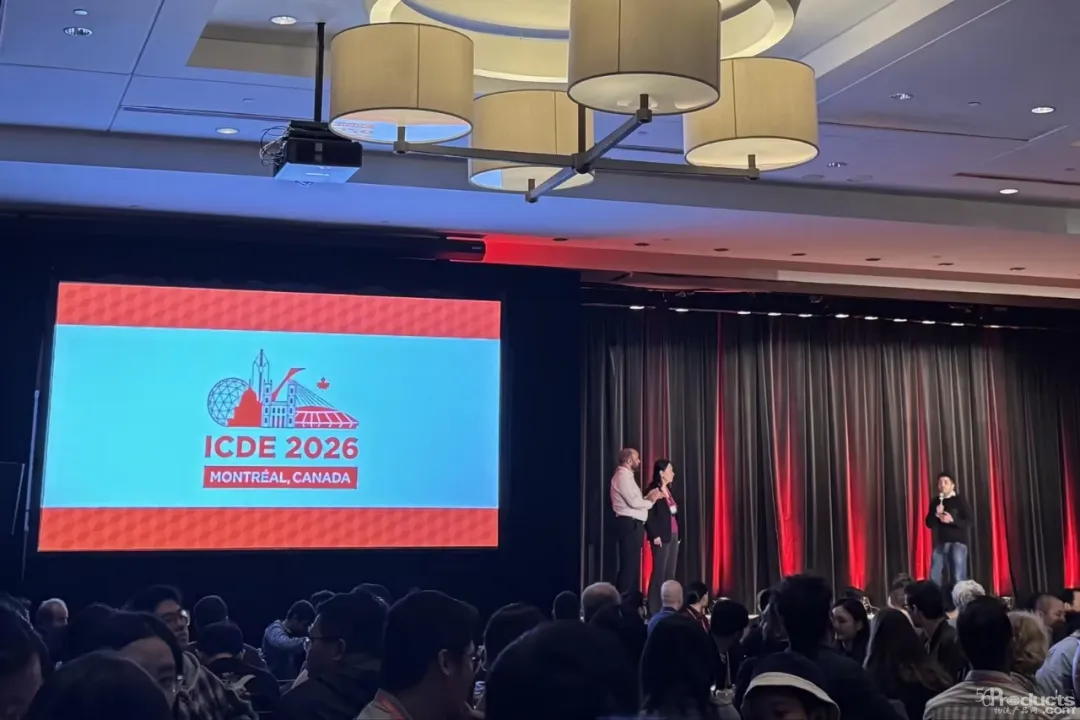
ICDE国际数据工程会议,全球数据库与数据工程领域三大顶会之一,被公认为数据界的“学术奥运会”,代表该方向的全球最高学术水准。
过往在这个舞台亮相的,大多是全球顶尖高校实验室,以及谷歌、微软、阿里、华为等科技巨头的前沿研究团队,录用率常年维持在25%左右,评审维度涵盖算法创新性、工业适用性、规模化验证,每一项拎出来都是硬门槛。
顺丰科技能够出现在2026年的名单里,看似意外,实则水到渠成。
这些年顺丰在算法领域的积累,行业内有目共睹。但ICDE毕竟是以数据库和系统架构见长的学术会议,顺丰科技这次上榜的方向是时序预测,一个横跨统计、机器学习和运筹优化的交叉领域。论文能在这个舞台上被接收,意味着不仅算法本身要足够创新,还要经得起全球同行在工业适用性、规模化验证等多个维度的严格审视。
简单来讲,这个来自顺丰科技与浙江大学、浙江工业大学联合研发的超轻量、超快、超准的时序预测AI模型Li-Net,是仅有0.5MB的极小模型,本质是一个AI预测工具,专门用来算未来的。
它能结合季节、促销、地域等多重因素,精准预判货量、运力等关键业务趋势,即便数据不足的工业场景,也能实现高精度预测。
那么,顺丰这个“黑科技”到底强在哪?这项技术突破,对整个物流行业又意味着什么?
01
物流时序预测
困在“不可能三角”里太久
要理解顺丰科技这次突破的意义,得先看清物流预测这件事到底有多难。
1)单变量预测,在物流场景里是个伪命题。
传统时序预测模型的工作方式,是找一条历史曲线,根据曲线的趋势预测未来。比如根据某个网点过去30天的日均揽件量,预测明天会有多少件。这种方法在学术数据集上效果不错,但放到真实的物流网络里,很难落地适配复杂的业务场景。
因为物流网络是由成百上千条相互关联的曲线组成的。一个SKU的销量涨跌,往往跟它周边SKU的销量高度相关;一个分拨中心的吞吐量,跟周边数个网点的发件量、数条干线的运力、甚至某个区域天气状况都有关联。
传统模型把每条曲线单独看,容易忽略多通道关联与传导规律,得出的结果自然和实际运营情况存在出入。
说到底,问题不在于传统算法的技术精度不够,根源是没找到合理利用跨通道信息的方法,无法有效平衡噪音和信号。
2)Transformer够准,但工业场景成本与时效扛不住。
最近几年,Transformer架构几乎包揽了时序预测学术圈的各类榜单,iTransformer、PatchTST、TimeMixer等模型相继刷新精度记录。这些模型确实强,但强是有代价的:全量注意力机制意味着对所有时间步、所有特征通道做两两计算,计算复杂度呈平方级上升。序列越长,内存占用和推理时间增长得越快。
放到真实的工业场景里,短板会被无限放大。某世界500强快消客户在做供应链预测时,使用特征工程+lightgbm架构的解决方案训练一次需要20个小时;顺丰自己的亿级件量预测任务,单次计算耗时超过两个半小时。在时效性要求极高的物流调度场景里,这个等待时间是没法跟上业务决策节奏的。
更关键的问题是部署成本。主流Transformer类模型体积普遍在几十MB到几百MB级别,推理需要GPU支持。对于大多数中小企业而言,自建这套基础设施的成本,远超预测精度提升带来的收益。
3)多模态信息,无法有效融合,影响精度。
物流场景里实际上有大量尚未被充分利用的信息,比如商品的图片和文字描述、节庆运营状态、天气数据、区域消费偏好、甚至仓库的实时库存水位。这些非结构化信息,传统时序模型“看不见”,只能靠人工一点点做特征拆解,不仅费时费力,而且提取质量参差不齐。
一个很直观的例子:预测某款食品的销量,如果模型能读懂商品的保质期、配料表甚至包装规格,就能比只看历史销量的模型更早预判。比如保质期临近了,系统会建议优先出库;规格变大了,也能提前预判经销商的补货节奏。这些经营逻辑,业内人都能看明白,但传统模型很难自主消化。
4)小数据场景,是被行业长期忽略的绝大多数。
头部企业有足够的数据量支撑深度学习模型训练,但物流行业里数量更多的,是中小承运商、区域配送商、快递快运的区域网点,这些场景的数据积累往往不足,用主流深度学习模型训练,容易过拟合,预测结果反而不如简单的统计方法。
精度、效率、多模态融合,三者好像有个隐形的天花板,同时做到极致的难度极高,这就是时序预测领域里说的“不可能三角”。行业迫切需要轻、准、快、融、稳的新一代工业级预测方案。
02
Li-Net正面拆解:
三项突破,一次说清
此次顺丰科技联合高校团队入选ICDE的论文成果,核心是提出了Li-Net轻量级智能预测模型,在精度、效率和泛化能力三个维度上同时取得突破。三项关键技术创新,构成了这个突破的底气。
第一点是,稀疏注意力+轻量MLP架构,“盯”最关键的,把算力省下来。
传统全量Attention机制,是对所有时间步、所有特征通道做两两相关计算,本质上是在“平均对待”每一个数据点。但真实的时间序列里,不是每个时间点都同样重要,比如节假日高峰、月末账期、突发促销,这些特殊节点才是决定预测精度的关键。
Li-Net的做法,是引入Top-K稀疏注意力机制:只保留与当前预测最相关的K个时间步和K个特征通道,把O(L²)的计算复杂度大幅压缩。同时,Li-Net整体采用基于MLP的轻量级架构,规避了传统全量注意力的高额算力开销。
内部实测数据就是最有力的证明:
十亿级海量件量预测场景,每日任务耗时从集群151分钟压缩至单机11分钟,效率提升14倍;
弹性资源使用维度,CPU推理成本节约46倍;
某世界500强快消客户的供应链预测场景中,模型训练时长从20小时压缩至10分钟,效率提升约120倍,服务器投入成本减少5倍。
第二点是,双维度动态压缩,让模型学习“举一反三”。
时间维度压缩与通道维度压缩同时进行,这是Li-Net在建模思路上的核心创新。
时间维度压缩,负责提取不同时间尺度的周期特征(年周期、月周期、特定节假日的规律),模型能从历史数据中自动学习出这些复杂周期性模式。
通道维度压缩,负责跨SKU、跨网点的信息聚合。比如,预测A款酸奶的销量,如果能同时参考B款、C款酸奶以及周边品类牛奶的销售规律,精度会明显高于只看A款本身。
两个维度的压缩相辅相成,使得模型在小数据场景下依然具有较强的泛化能力。也就是说,即便某个新SKU只有几百条历史记录,依托通道聚合机制,模型依然能给出精度可用的预测结果。
第三点是,统一多模态融合框架,让文字、图片和数字统一嵌入学习。
这是Li-Net最具工程创新性的一点:提出了一个统一的多模态信息融合框架,将日期、网点、商品、运营状态等异构信息,与商品文字描述、图片特征等非结构化信息统一嵌入学习,并智能聚合相似品类特征以强化联合学习效果。
具体来看,非结构化的多模态特征(商品图片、文字描述)通过多模态大模型接口提前缓存embedding向量;结构化特征(日期、网点属性)使用可学习embedding嵌入网络。两类特征在统一的表示空间中对齐后,再进入预测主干网络联合学习。
换句话说,模型不仅“看得懂”数字序列,还能“读懂”商品描述里暗含的品类特征、“看懂”产品图片里的包装规格信息。
顺丰科技团队在ETT、电力、气象、交通、M5零售5大国际权威数据集上做了全面验证,结果显示预测精度(MAE/MSE)均显著优于iTransformer、PatchTST等当前主流SOTA模型。
更关键的是,Li-Net模型体积平均仅约0.5MB,却可稳定支撑半年至一年的长周期业务预判,适配供应链多变量、高波动的业务特征。
长周期预测能力对于供应链规划至关重要。备货周期、采购计划、产能安排,都依赖对未来数月趋势的准确判断。大多数模型在预测步数超过336步(中长期)后,预测精度就开始明显衰减,而Li-Net在720步乃至更长周期上依然保持稳定表现。
值得一提的是,此次科研成果也是顺丰科技产学研协同创新的实践典范。顺丰提供真实业务场景、产业数据与算法能力,浙江大学和浙江工业大学提供理论支撑,形成“产业痛点→学术创新→工程落地→业务赋能”的完整闭环,让科技能力服务于产业升级。
03
技术落地验证,能力向外延伸
技术突破本身有价值,但业内人更关心的是,这套东西,经得起落地验证吗?
从顺丰科技给出反馈来看,目前Li-Net已在内部的件量预测、分拨流量预测、运力调度、网络规划、时效预测和库存预测六个核心业务场景落地。
这六个场景,基本覆盖了顺丰日常运营调度的决策节点,从最前端的揽收预测,到中端的分拨调度,再到末端的运力分配,全部串联运行。
在双十一、年货节等业务高峰期,这套系统的价值进一步被放大。依托毫秒级的预测能力,支撑百万级网点的实时动态调度,减少了运力浪费,节约了人力成本,缓解了中转拥堵,整体运营成本得到了降低。
更值得关注的是,这项技术在顺丰自身业务之外的延伸潜力。
许多工业场景数据量比较小,不足以支撑训练主流的深度学习模型。而Li-Net有较强的聚合能力,对小数据集的噪音有较强的兼容性。
这也意味着,物流和零售行业的数智化门槛,被实实在在拉低了。不需要堆积海量历史数据,也不需要重金采购GPU集群,中小企业同样可以接入这套预测能力。
说完技术,回到一个更根本的问题:为什么是顺丰,而不是其他?
答案就藏在时序预测的本质里。
时序预测模型的精度上限,本质上由两个因素决定:算法设计决定了模型能利用多少信息;训练数据的质量和规模决定了模型能学到多细颗粒度的模式。
前者靠算法团队的能力,后者靠企业在真实业务场景中多年积累的数据资产。
顺丰的优势在于,它同时拥有这两个条件:日均亿级包裹的业务体量提供了充足且多维的训练数据,十余年持续投入的科技团队提供了算法攻坚的能力。这种组合,在物流行业里属于稀缺配置,很难被复制。
还有一个更值得关注的维度:做好比做完更重要。
任何数智化产品,要持续稳定地在真实业务中产生价值,才算跑通闭环。预测精度每提升1%,对应的库存积压减少、资金占用降低、货损率下降;城配路线优化、港口集装箱调度改进、全网运力排布,这些任务以往多依赖人工经验,现在有了持续可用的预测能力,企业可以获得成本降低或收入增长。
这也是行业基础设施发展的必然路径。物流数智化底层的预测、调度、规划能力,需要有足够大的业务体量、足够长的数据积累、足够强的投入意愿,才能形成可复制的技术方案。顺丰做这件事,既是自身竞争力的升级,也是行业推进数智化转型的一个参照路径。
能够入选ICDE这样的顶会,本质上是顺丰把内部技术攻关拿到了全球同行面前接受检验。这种开放透明的姿态,是技术领先的底气,也是带动行业技术进步、共建标准的重要方式。
看似一个仅0.5MB的模型,背后是多年数据的沉淀、产学研协作的机制,和把预测打造为数智化基础设施的长期坚守。
物流行业的确定性,既需要稳固的运营底盘与全域网络资源作支撑,更离不开硬核科技的驱动。而以Li-Net为代表的技术突破,正是物流行业向更高阶数智化发展的重要一步。

价格:面谈

价格:面谈

价格:面谈
价格:面谈
破局与新生:物流新能源革命的全球图景与时代使命06月16日 15:03
从人工分拣到智能仓:数字物流如何支撑万亿电商市场?06月16日 15:13
新时代鞋服物流与供应链面临的变革和挑战03月07日 20:38

点赞:这个双11,物流大佬一起做了这件事11月22日 21:43
物流管理机构及政策分布概览12月04日 14:10